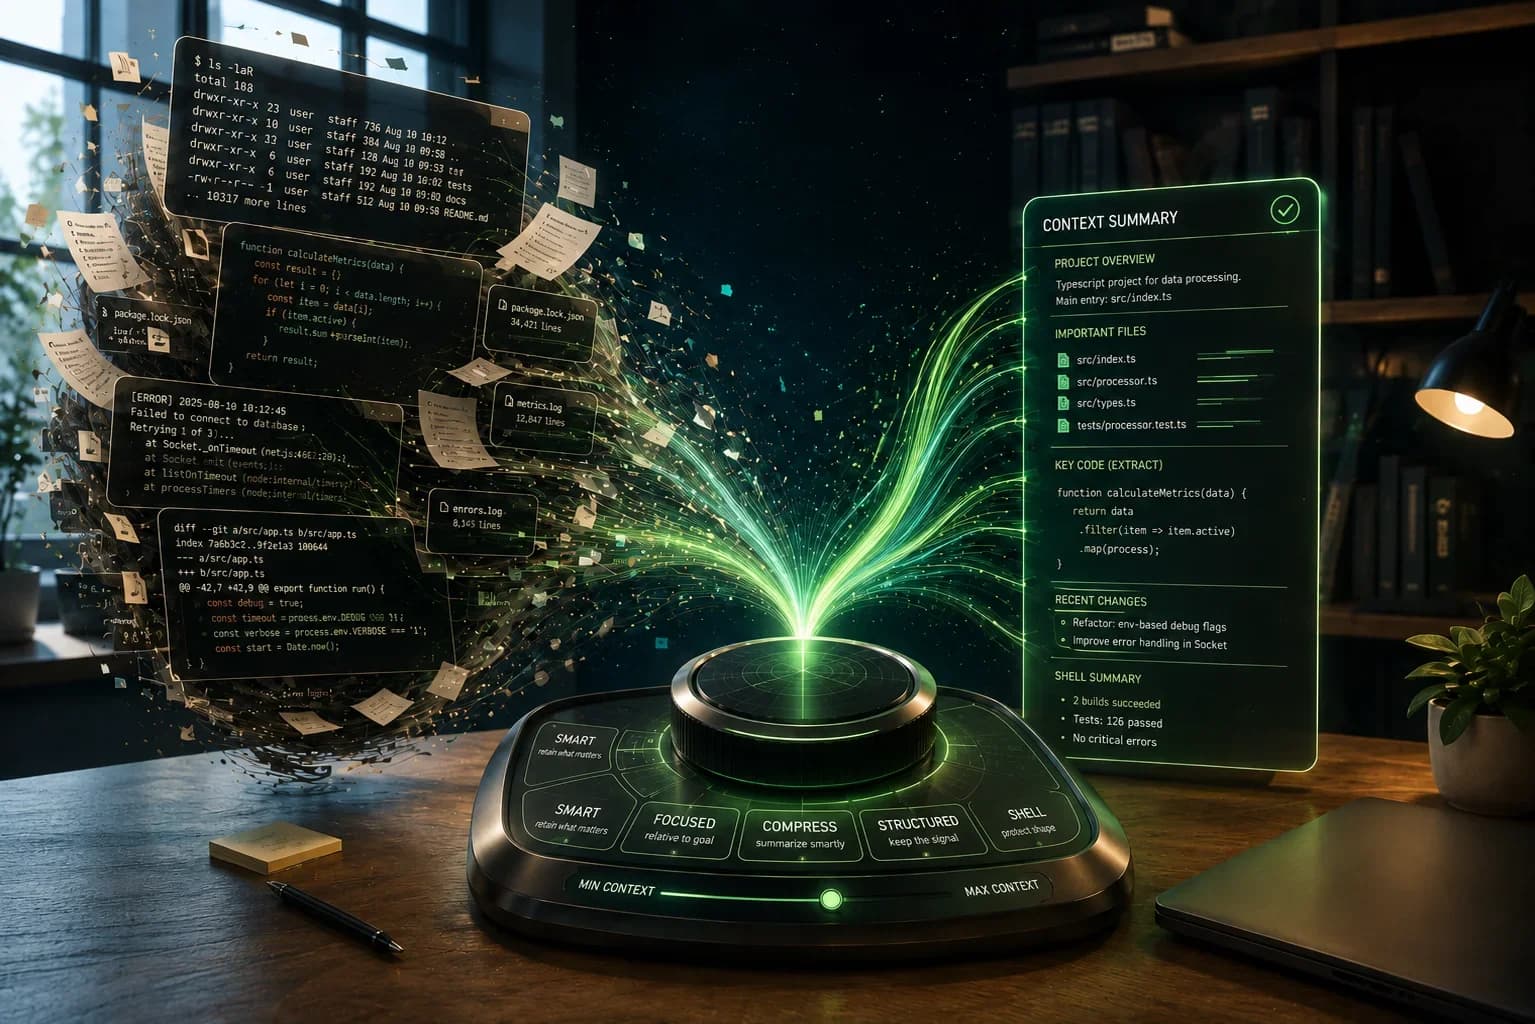
Обычный инструмент экономии токенов берёт готовый поток данных и делает его короче. LeanCTX задаёт вопрос на шаг раньше: а нужно ли агенту читать этот файл целиком.
Разница не косметическая. Если модели нужно знать, какие функции экспортирует модуль, она может получить список сигнатур на двадцать строк вместо шестисот строк исходника - и тогда сжимать уже нечего, потому что лишнее просто не появилось. Отсюда и позиционирование: это не компрессор, а слой, который решает, что попадёт в окно.
Заодно это один из самых крупных проектов в теме, и разбирать его интересно именно поэтому - на его примере хорошо видно, чем платят за такую полноту.
Десять способов прочитать один файл
Начну с механизма, ради которого проект и стоит смотреть. У операции чтения есть параметр режима, и README называет десять. Оговорюсь сразу: это число из документации, а в коде вариантов больше - перечисление режимов содержит семнадцать, включая служебные вроде побайтового чтения, чтения с якорями по строкам и укороченного полного. Ниже разобраны те десять, которые проект выносит наружу как рабочие.
| Режим | Что возвращает | Когда нужен |
|---|---|---|
| `auto` | LeanCTX выбирает сам | значение по умолчанию |
| `full` | весь файл, но через кэш | файл будут править |
| `map` | импорты и внешний интерфейс | понять устройство файла |
| `signatures` | сигнатуры функций, классов, типов | нужен только API |
| `aggressive` | сильно урезанное представление | очень большой файл |
| `entropy` | строки, отобранные по информативности | огромный текст, нужны плотные куски |
| `task` |